はじめに
データマネジメント部の岩切公佑(iwakiriK)です。主に、KADOKAWA グループのデータパイプラインの開発・運用を担当しています。
昨年(2025年)、エンジニア界隈で「Claude Code がすごい」と大きな話題になりました。これを受け、データマネジメント部でも導入の効果や実用性を検証すべく、PoC (概念実証)を実施することとなりました。その一環として、私たちのチームは「日々のデータ加工処理の自動生成にも Claude Code を適用できないか?」という着想に至りました。
具体的には、メダリオンアーキテクチャにおける「ブロンズレイヤーからシルバーレイヤーへのデータ加工処理」を対象とし、Claude Code を用いた自動生成がどの程度実用に耐えうるかを調査・検証しました。本記事では、その検証内容と得られた知見について紹介します。
検証の前提
検証対象の選定理由:なぜ「ブロンズからシルバー」なのか?
本検証では、自動化の対象とする加工処理を「ブロンズからシルバーへのデータ加工処理」に絞ることにしました。このレイヤー間の加工(クレンジング、型変換、構造の平坦化など)は、複数のデータ加工処理で類似した定型処理を多く含んでいることから、「入出力のデータカタログの組み合わせから、高精度に自動生成できるのではないか」と考えたためです。
検証した自動化の手法について説明する前に、前提知識として、私たちが実践している「データカタログの管理方法」と「ブロンズからシルバーへの加工処理の実装方法」を紹介します。
データカタログの管理方法
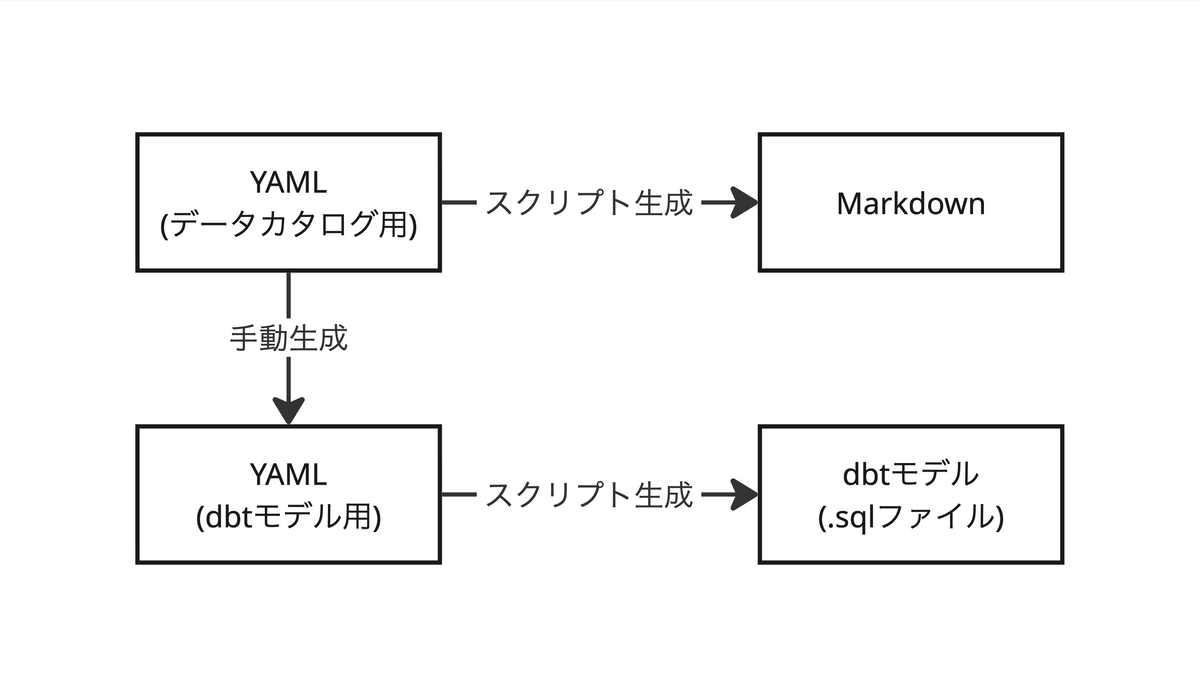
私たちのチームでは、データスキーマやメタデータなどをデータカタログとして、ブロンズレイヤーとシルバーレイヤーの両方で一元管理しています。このデータカタログは、記述や管理のしやすさを考慮して YAML 形式を採用しており、用途に応じてスクリプトで Markdown ファイルに変換・出力する構成をとっています。
また、この YAML ファイルに対して、CI 上で JSON Schema を使用した構造・許容値のバリデーションを行っています。こうすることで、「構造の正しさ」は機械によって担保されるため、人間によるレビューでは「値が正しいか(想定通りか)」という本質的な確認のみに集中することができます。
※なお、KADOKAWAでデータカタログシステムを導入するまでの紆余曲折 でも紹介している通り、私たちの部署ではデータカタログシステムとして「タヅナ」を導入しています。今回ご紹介している YAML ファイルは、タヅナに情報を登録・集約する前段階において、データパイプライン開発チーム内で使用する内部資料という立ち位置となっています。
ブロンズからシルバーへの加工方法
データ加工処理についても、データカタログと同様に「定型作業のコード化と自動化」を基本方針としています。
具体的には、加工内容を YAML 形式で管理し、Jinja テンプレートでのレンダリングを経て、最終的にスクリプトで dbt モデル(.sql)を生成しています。この手法により、前述の「機械的なバリデーションによるレビューの簡略化」だけでなく、生成される dbt モデルの品質均一化(標準化)も同時に実現しています。
ここまでの内容をまとめると、以下の図のような運用フローになります。
なお、使用技術などの詳細については、Amazon MWAA + Step Functions (+ Snowflake × dbt) による大規模データパイプライン構築事例紹介 にて触れています。興味のある方はご一読いただけると幸いです。
自動化の検証
自動化パターン
現在の運用をベースにすると、Claude Code を組み込むアプローチとして以下の4パターンが考えられます。
- データカタログ (YAML) ──[Claude Code]──> dbt モデル (.sql)
- データカタログ (YAML) ──[Claude Code]──> dbt モデル生成用 YAML ──[スクリプト]──> dbt モデル (.sql)
- データカタログ (Markdown) ──[Claude Code]──> dbt モデル (.sql)
- データカタログ (Markdown) ──[Claude Code]──> dbt モデル生成用 YAML ──[スクリプト]──> dbt モデル (.sql)
Markdown よりも、JSON Schema によるバリデーションで構造やルールが厳密に管理されている YAML の方が AI にとっても解釈しやすいと考えられるため、Markdown をインプットとする選択肢(3, 4)は除外しました。
インプットを YAML に絞った以下の2つのパターンについて、実際の検証内容を紹介します。
方針1: データカタログ(YAML)から、直接 dbt モデルを生成する
まずは、Jinja テンプレートを介さず、データカタログから直接 dbt モデル(.sql)を生成するアプローチを検証しました。
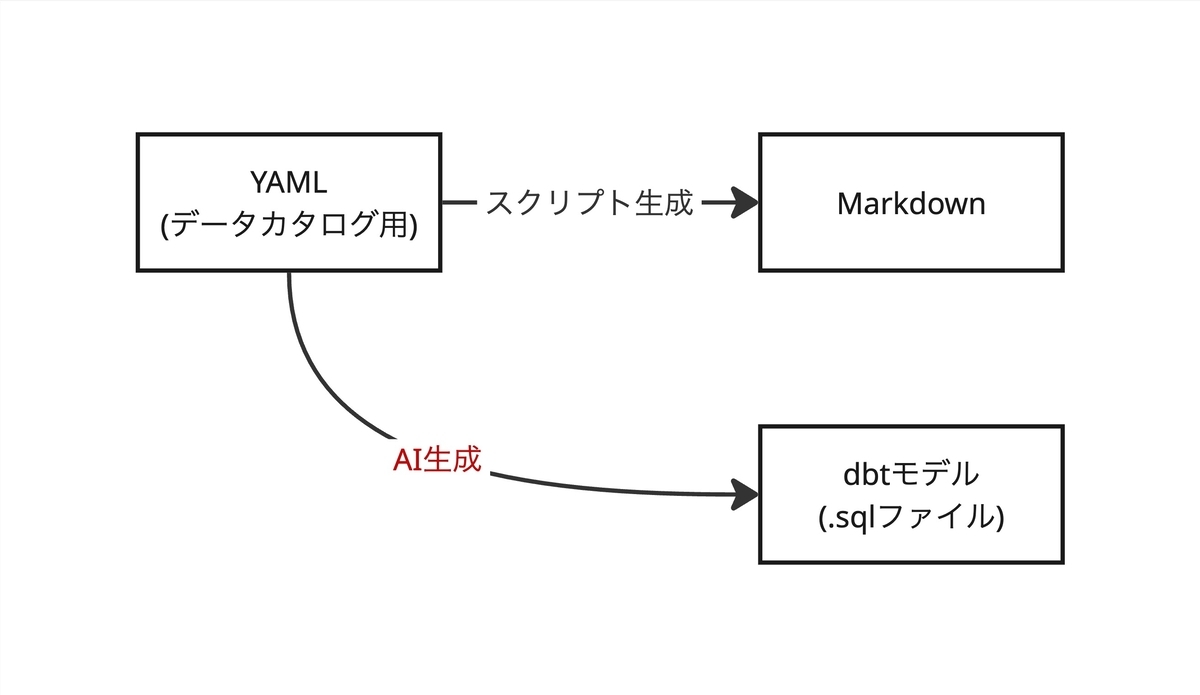
コンテキストファイル(CLAUDE.md や SKILL.md など)に、チーム内での定型の加工処理に関する知識を記載し、入出力のデータカタログと掛け合わせることで、自動生成を試みました。
しかし、実際に検証を進めると3つの大きな課題に直面しました。
課題1: コンテキストファイルの肥大化
共通仕様や実装パターンを AI に正しく理解させるために記述量が増え、コンテキストファイルが肥大化しました。適切な粒度でファイルを分割するといった対策も考えられますが、これらのドキュメントを最新の状態にメンテナンスし続けるのは現実的ではないと判断しました。
課題2: 共通仕様を厳密に遵守させる難しさ
LLMの性質上、出力の非決定性(ブレ)を排除しきれず、共通仕様に違反したコードが生成されることが多々ありました。そのため、生成された dbt モデルが想定通りの挙動になっているかを保証することは困難でした。
課題3: レビューコストの増加
生成された SQL が「本当に想定通りの挙動になっているか」を人間が担保しなければならず、かえってレビューコストが上がる懸念が浮き彫りになりました。
これらの課題により、この方法を実運用へ適用するのは困難である、という結論に至りました。
方針2: データカタログ(YAML)から、dbt モデル生成用 YAML を生成する
方針1の課題を踏まえ、次は dbt モデル生成用 YAML を生成させるアプローチを検証しました。
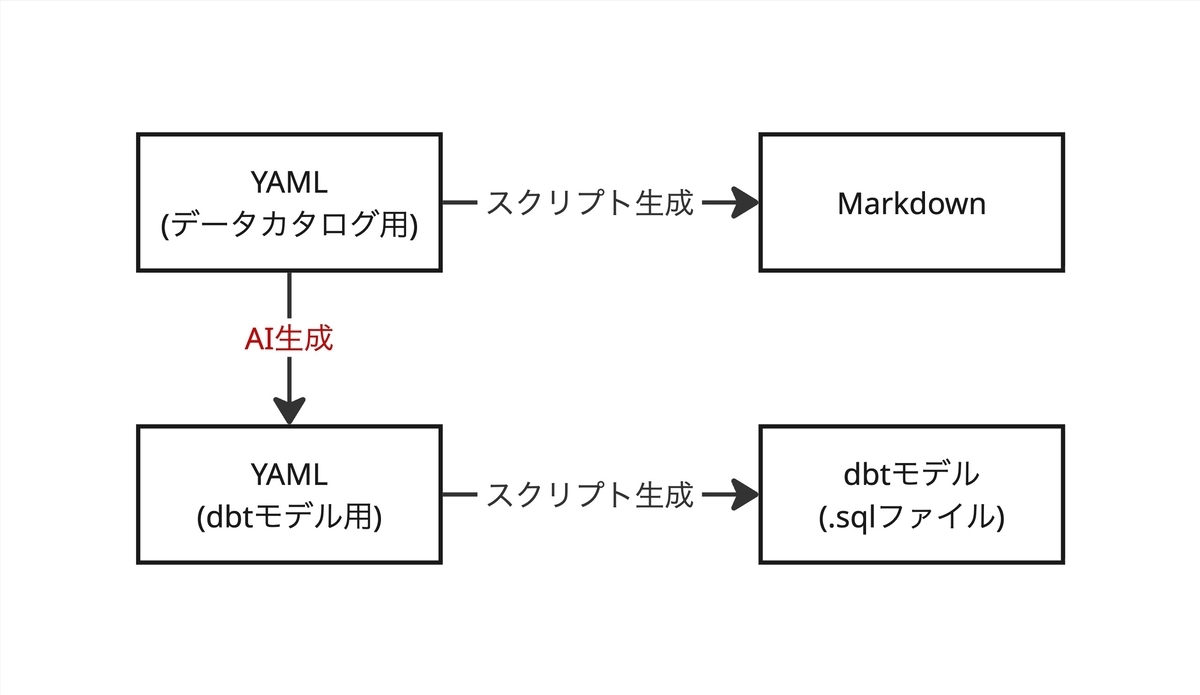
方針1のような自然言語によるルールの記述をやめ、シンプルに成果物となる dbt モデル生成用 YAML の JSON Schema をインプットとして与えました。また、Claude Code が持つ「プロジェクトの文脈を自律的に理解する」という強みを活かし、詳細なプロンプトによる指示は行わず、リポジトリ内にある既存の YAML ファイルを Few-shot(お手本)としてそのまま読み込ませました。
結果として、精度の高い YAML を生成することができました。 仮に出力のブレ(構造の誤りなど)が発生したとしても、JSON Schema によるバリデーションエラーを Claude Code が自律的に再修正してくれます。このサイクルを回すことで、機械的にブレを排除できるため、人間の手による手直しがほぼ発生せず、「これなら十分に実用に耐えうる」という確信を得ることができました。
おわりに
本検証では、Claude Code を用いて、メダリオンアーキテクチャにおける「ブロンズからシルバーへのデータ加工処理」の自動生成にチャレンジしました。
今回の検証を通じて、「AI に厳格さが求められる成果物(SQL、データスキーマなど)を生成させる場合は、型・構造が明確で CI によるバリデーションが可能なフォーマット(今回の検証であれば YAML)を出力ターゲットにすると良い」という知見が得られました。
私たちのチームでは、データカタログやデータ加工定義以外でも YAML で管理している領域が多くあります。そのため、今後の展望として、他領域でも Claude Code による自動生成が有効かどうかの検証を進めていきたいと考えています。また、今回の検証ではチーム内向けの資料をソースに用いましたが、データカタログシステム「タヅナ」には LLM 向けに YAML 形式でエクスポートする機能も備わっているため、こちらをソースとした自動化についても検証していきたいと考えています。
本記事が、皆様のデータエンジニアリングの運用の一助となれば幸いです。
